SayPlan에서 RT-1, RT-2, OXE, Diffusion Policy, ACT, Octo, OpenVLA, Helix, GR00T N1, SmolVLA, FAST, π 시리즈, Astra, 그리고 Decision Model까지
기술 에세이 · 아키텍처와 시간축으로 읽는 로봇 학습 · 2026년 11월
불과 몇 년 전만 해도 로봇에게 말로 일을 시키는 건 공상과학에 가까웠다. 오늘날엔 데모 영상만 보면 로봇이 사람 말을 척척 알아듣고 컵을 치운다. 하지만 막을 걷고 안을 들여다보면, 두 대의 로봇이 똑같이 컵을 옮기더라도 머릿속에서 돌아가는 원리는 하늘과 땅 차이다. 어떤 모델은 작업 순서만 읊어주고 빠지고, 어떤 모델은 손끝이 가야 할 3차원 좌표를 직접 계산해 뱉는다. 모델이 직접 푼 숙제와 아래단 제어기에 떠넘긴 숙제가 완전히 다른 셈이다.
이 글은 최근 몇 년 사이 로봇 학습의 판을 바꾼 연구들을 하나의 연대기로 엮는다. 기준은 단 하나, “로봇을 움직이는 숫자를 누가, 무엇을 보고, 얼마나 자주 정하는가”다. 기호 계획에서 직접 행동을 배우는 정책으로, 다시 시간과 다중 모달 분포, 이중 속도 구조, 주파수 압축, 강화학습, 그리고 범용 VLM이 직접 행동 좌표를 뱉기까지의 역사를 따라간다.
0. 네 개의 트랙으로 보는 지도
그림 0을 가로로 읽으면 2022년부터 2026년까지의 시간순 연대기가 보이고, 세로로 읽으면 로봇 학습을 밀어 올린 네 개의 기술 트랙이 드러난다. 본문 1~4부가 시간의 흐름을 따라 이야기를 푼다면, 이 네 트랙은 각 연구 집단이 서로 다른 문제의식을 쥐고 파고든 네 갈래의 길이다.
| 트랙 | 붙잡은 핵심 질문 | 대표 계보 |
|---|---|---|
| Track 1 · 기호 계획 · 범용 VLM | 로봇 데이터 없이도 언어·시각 지능만으로 어디까지 제어할 수 있나? | SayCan → SayPlan → System 2 → GPT-6 Astra → Decision Model |
| Track 2 · 토큰 VLA · 데이터 개방 | 행동을 언어 토큰처럼 다루고 데이터를 모으면 범용 정책이 될까? | RT-1 → RT-2 → OXE/RT-X → Octo·OpenVLA → FAST |
| Track 3 · 시간 Chunk · 연속 분포 | 오차 누적과 다중 경로 평균 함정을 어떻게 깨고 부드럽게 움직일까? | Diffusion Policy·ACT → π0 → Helix·GR00T N1·SmolVLA |
| Track 4 · 일반화 · RL · 맥락 조건화 | 낯선 집, 실패 데이터, 뒤섞인 전략까지 품으려면 무엇이 더 필요한가? | π0.5 → π*0.6(RECAP) → π0.7 |
이 네 트랙을 머릿속에 띄워둔 채 1부로 들어가면, 각 논문이 왜 하필 그 시점에 등장해 앞선 트랙의 한계를 찔렀는지 훨씬 입체적으로 읽힌다.
1. 말과 모터 사이의 거대한 간극
어질러진 책상 앞에 로봇을 세워두고 이렇게 말해 보자.
“손님 오기 전에 책상 좀 치워줘. 깨끗한 컵은 선반에 올리고, 쓰레기는 버려.”
사람에겐 3초면 끝나는 이 지시가 로봇 팔의 모터 전류로 바뀌기까진 까마득한 거리가 있다. 먼저 ‘치운다’는 추상적 뜻을 풀어야 하고, 컵과 쓰레기를 가려내야 한다. 선반 위치를 파악한 뒤엔 손가락을 어느 각도로 뻗어 컵을 쥘지, 어디로 들어 올려 옮길지 궤적을 짜야 한다. 옮기다 컵이 미끄러지면 그 순간 눈으로 다시 보고 자세를 고쳐 잡아야 한다.
역사적으로 연구자들은 이 기나긴 사슬의 어디까지를 학습 모델에 맡길지 두고 끊임없이 줄다리기를 해왔다. 모델이 내놓는 출력은 크게 네 층위로 갈린다.
| 출력 층위 | 예시 | 실행기에 남는 몫 |
|---|---|---|
| 의미적 하위 작업 | 컵을 선반으로 옮겨 | 어느 컵인지 찾고, 잡고, 옮기는 일 전부 |
| 스킬 호출 | pick(cup_3), place(shelf_2) |
스킬 안쪽의 인식·경로 생성·접촉 제어 |
| 수치 행동 | 말단 위치·자세·그리퍼 목표값 | IK, 궤적 추종, 하위 서보 제어 |
| 실행 프로그램 | 관측을 읽어 접근·파지·재시도를 도는 코드 | 코드 실행과 센서·제어기 구동 |
컵을 고르는 눈과 컵을 쥐는 손놀림은 전혀 다른 능력이다. 그래서 어떤 시스템을 평가할 때는 ‘성공했나’만 볼 게 아니라 무엇을 입력받고, 무엇을 출력하며, 누가 그걸 실행하고, 결과를 얼마나 자주 다시 보는지를 따져야 한다.
이 관계를 수식으로 고정해 두자. 시각 t의 관측을 ot(카메라 이미지 It, 관절 상태 qt 등), 사용자의 지시를 ℓ, 관측·행동 이력을 ht라 하자. 한 시점의 수치 행동은 at, 앞으로 H개 시점에 걸친 행동 묶음은 At다.
여기서 d는 로봇 제어 인터페이스에 맞춰 잡은 행동 차원이다. 외팔 로봇의 말단 이동과 그리퍼만 쓰면 7차원이고, 양팔 관절 목표를 다 다루면 차원이 훨씬 커진다. 같은 7차원이라도 절대 위치인지 변위인지, 회전 표현과 기준 좌표계가 무엇인지에 따라 전혀 다른 언어가 된다.
2. SayPlan: 언어 모델에 지휘봉을 쥐여주다
초기 LLM 로보틱스 연구자들의 선택은 명쾌했다. 이미 세상의 상식을 꿰고 있는 거대 언어 모델에게 ‘계획’이라는 지휘봉을 쥐여주고, 실제 손발은 검증된 고전 제어기와 스킬에 맡기는 것이다.
2023년에 나온 SayPlan은 그 정점을 보여준다. 건물이 여러 층과 방으로 나뉘어 있을 때, 모든 물체 정보를 프롬프트에 다 우겨 넣으면 LLM이 금세 길을 잃는다. SayPlan은 미리 짜 둔 계층적 3D scene graph(건물–층–방–물체)를 JSON으로 덤프해 두고, LLM이 API를 호출해 필요한 구역의 노드만 접었다 펼치며 탐색하게 만들었다. 큰 이동 구간은 Dijkstra 같은 경로계획기가 잇고, scene graph simulator가 돌려주는 피드백을 보고 말이 안 되는 작업 순서를 스스로 고쳐 나간다. S01

| 계획 단계 | 새로 확인하는 정보 | 출력 |
|---|---|---|
| 관련 공간 검색 | 접힌 그래프, 작업 지시 | 주방·선반이 속한 노드 펼치기 |
| 작업 계획 | 드러난 물체·상태·관계 | 이동, 컵 집기, 선반에 놓기 |
| 계획 검증 | 그래프 현재 상태와 동작 전제조건 | 어긋난 순서나 빠진 조건 지적 |
| 재계획 | 검증 피드백 | 수정한 상징 계획 |
| 실행 | 검증을 통과한 계획 | 별도 실행기를 통한 이동·조작 |
이 구조 덕분에 닫힌 냉장고에 컵을 넣으려다 문 여는 단계를 빼먹는 식의 논리 오류는 그래프 검증 단계에서 걸러진다.
하지만 곧 한계가 드러났다. 그래프 위에서 완벽하게 통과한 계획이라도 막상 로봇 손이 다가가면 카메라가 가려 있거나 컵이 미끄러진다. 상징 계획과 물리 접촉 사이의 간극을 메우려면, 아예 눈으로 보고 직접 숫자를 뱉는 정책이 필요했다.
3. RT-1: 스킬을 부수고 숫자를 배우다
사실 시간표를 거슬러 올라가면, SayPlan보다 한 해 먼저 정반대의 길로 뛰어든 실험이 있었다. 2022년 구글 로보틱스 팀이 내놓은 RT-1이다.
RT-1의 질문은 단순했다. “작업마다 제어기를 따로 짜지 말고, 수많은 시연 데이터를 거대한 Transformer 하나에 때려 넣어 자연어 조건부 단일 정책으로 만들 수 없을까?” 로봇 13대가 17개월 동안 13만 개가 넘는 에피소드를 묵묵히 수집한 끝에, EfficientNet과 TokenLearner, Transformer를 엮은 35M 모델이 탄생했다. S03 S04

| 항목 | RT-1 |
|---|---|
| 입력 | 최근 RGB 이미지 6장, 자연어 지시 |
| 출력 | 팔 7축 + 베이스 3축 + 동작 모드 1축 |
| 행동 표현 | 수치 행동 변수를 256개 bin으로 이산화 |
| 학습 방식 | 시연 행동 토큰에 대한 분류 손실 |
| 규모·수집 | 약 35M parameters · 130k episodes(700+ 지시) · 13대/17개월 · 3Hz |
RT-1은 연속적인 실수 값을 직접 회귀하는 대신, 각 행동 축의 범위를 256칸으로 잘게 쪼개 번호(token)를 맞히는 분류 문제로 바꿨다.
예측한 번호를 다시 실수로 되돌려 제어기에 넘기면 로봇이 한 스텝 움직인다. 그러면 카메라가 새 장면을 찍고, 모델은 그 장면을 받아 다음 스텝의 번호를 뽑는다.
RT-1은 언어 지시 하나로 수많은 조작을 3Hz 폐루프로 풀어냈다는 점에서 기념비적이었다. 하지만 뼈아픈 약점이 있었다. 세상의 상식을 몰랐다. 컵 옮기기를 아무리 연습시켜도 시연 데이터 바깥의 말—“졸린 사람에게 마실 걸 가져다줘”—을 걸면 그대로 굳어버렸다.
4. RT-2: 인터넷의 기억을 로봇 손끝으로
해법은 의외로 가까운 곳에 있었다. 이미 웹상의 엄청난 이미지와 글을 읽고 세상의 이치를 깨우친 거대 VLM을 그대로 데려와, 그 말칸 속에 로봇의 행동 숫자만 끼워 넣는 것이다.
2023년 등장한 RT-2는 웹의 vision-language 과제와 로봇 행동 데이터를 한데 묶어 함께 미세조정(co-fine-tuning)했다. PaLI-X나 PaLM-E 같은 거대 백본이 그림과 질문을 보고 텍스트 토큰을 뱉듯, 종료 여부·말단 변위 6축·그리퍼 1축으로 이뤄진 8개 행동 토큰을 나란히 토해내게 만든 것이다. S05
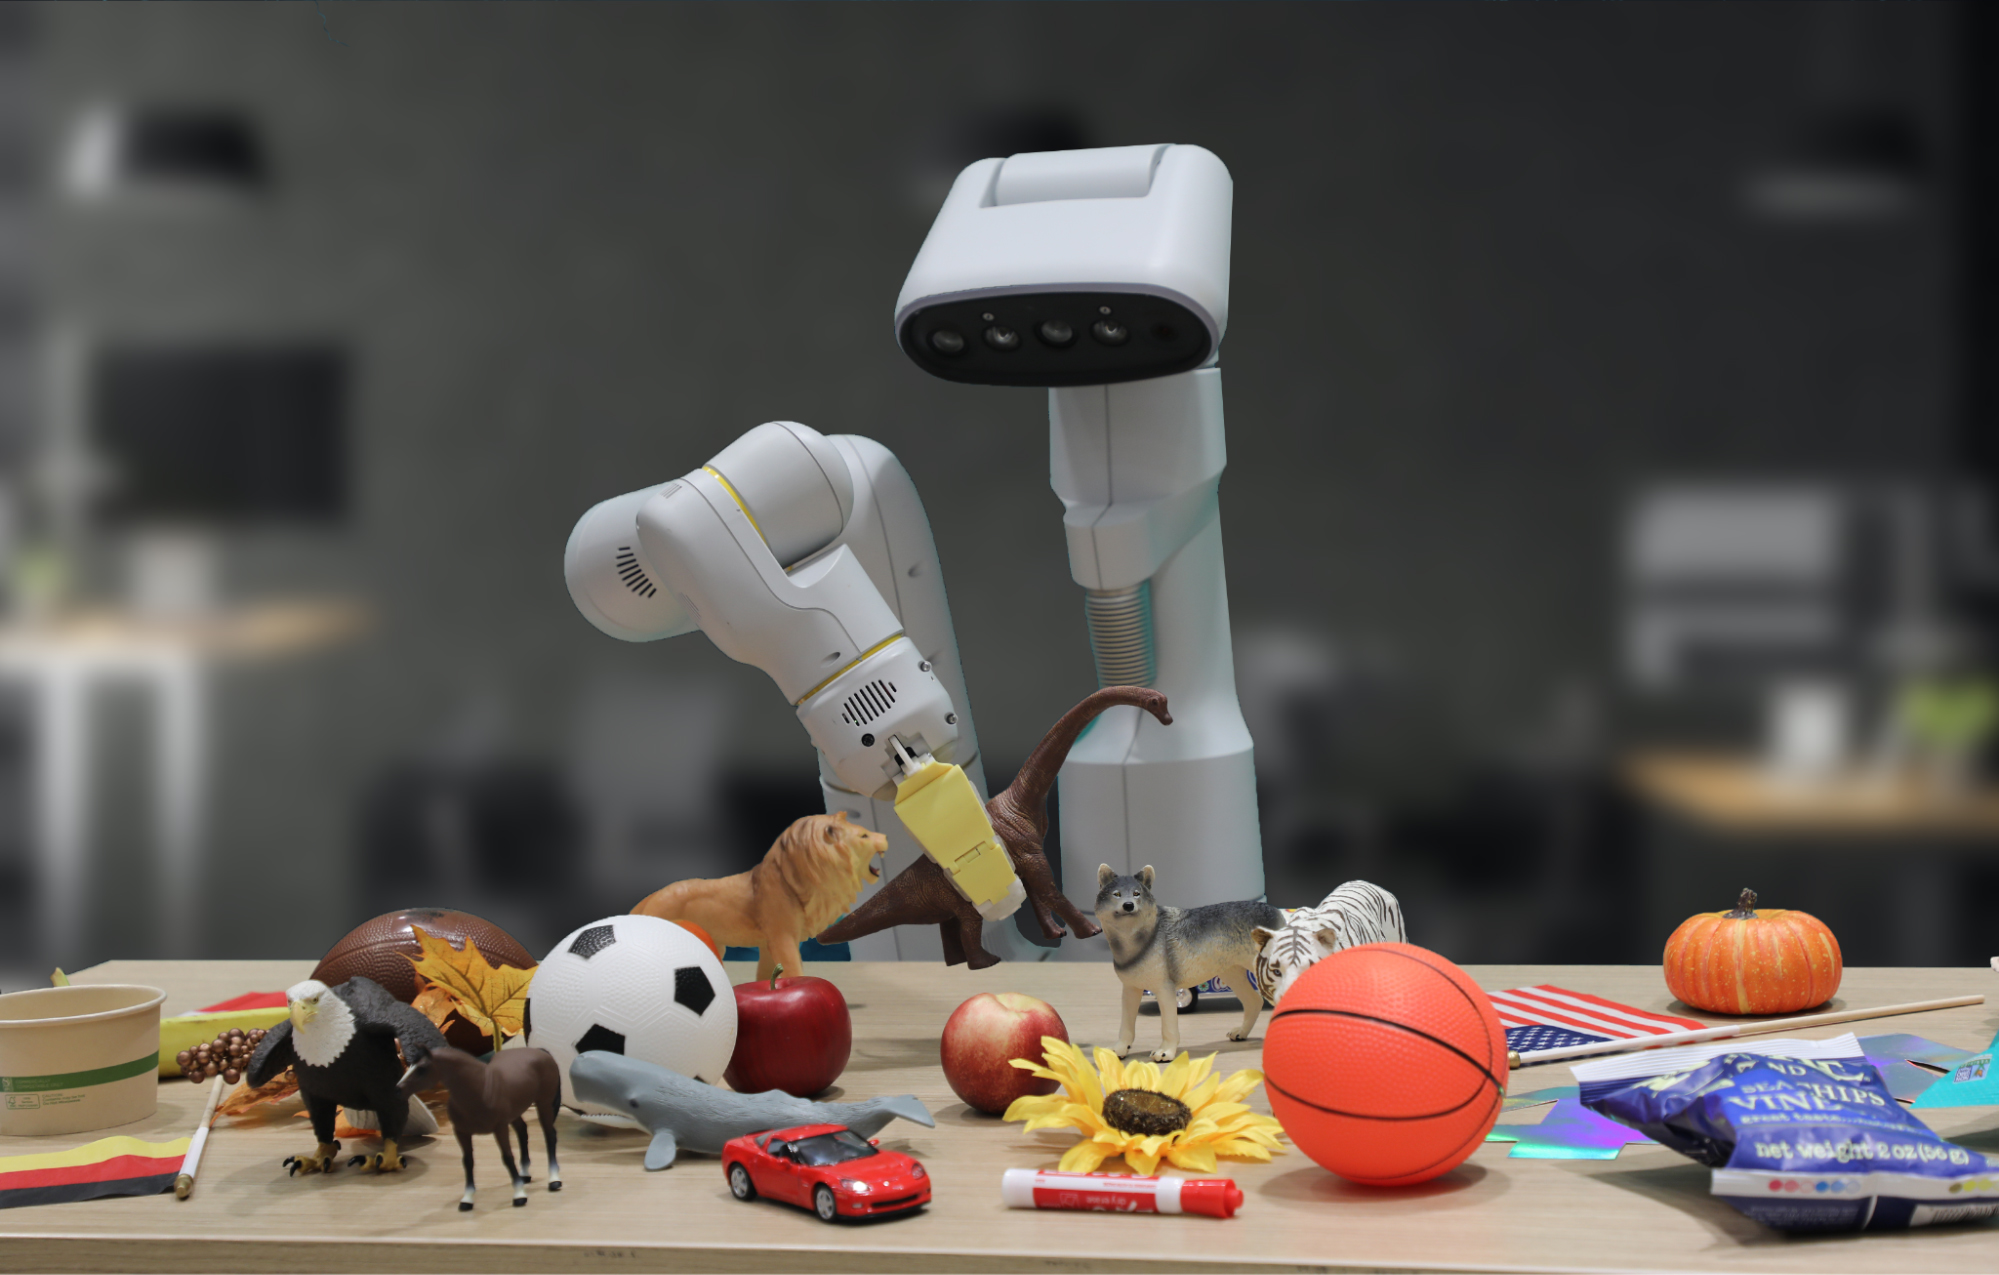
결과는 극적이었다. 로봇 시연 데이터엔 한 번도 등장하지 않은 “멸종한 동물 장난감을 집어줘”라는 명령을 듣자, RT-2는 웹에서 배운 공룡과 멸종의 관계를 떠올려 정확히 공룡 인형으로 손을 뻗었다. S06
이 지점에서 로봇 학습의 역사는 일반화를 둘로 갈라 보기 시작했다. 새 단어나 문맥을 보고 ‘무엇을 집을지’ 골라내는 건 의미 일반화고, 낯선 물리 조건에서 ‘새로운 손놀림’을 해내는 건 운동 일반화다. 웹 지식은 의미 일반화의 문을 활짝 열어젖혔지만, 시연에 없던 고속 공중 캐치 같은 새로운 손기술까지 공짜로 쥐여주진 못했다.
5. OXE, Octo, OpenVLA: 데이터와 코드의 개방
RT-2가 보여준 비전은 매혹적이었지만, 거대 기업의 닫힌 담장 안에 있었다. 더 큰 걸림돌은 데이터였다. 컴퓨터 비전에 ImageNet이 있었다면, 로보틱스엔 기관마다 제각각인 로봇 팔, 카메라, 좌표계만 흩어져 있었다.
2023년 10월, 전 세계 수십 개 연구실이 손을 맞잡고 Open X-Embodiment(OXE)와 RT-X 모델을 내놓으며 이 판을 뒤집었다. 22종 이상의 서로 다른 로봇 데이터를 RLDS 형식으로 통합해 학습시키자, 데이터만으론 절대 못 배웠을 동작이 다른 로봇의 경험으로부터 전이(cross-embodiment transfer)되는 현상이 실제로 확인됐다. S25

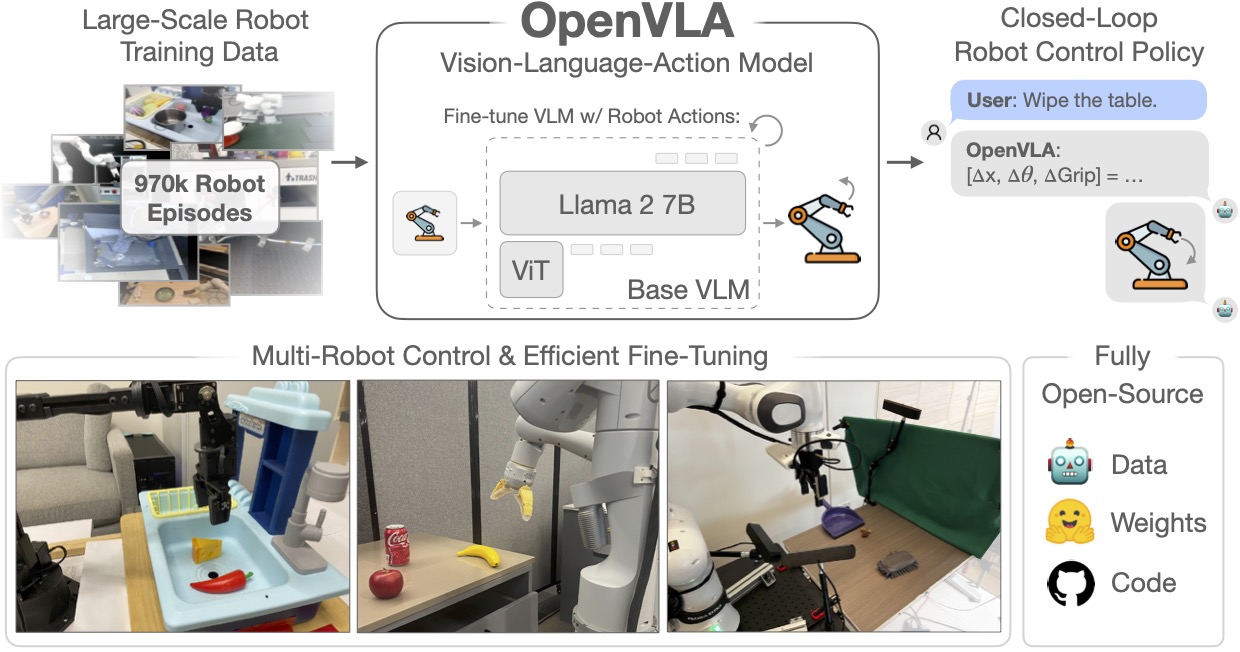
OXE라는 거대한 물줄기가 터지자, 2024년 봄 오픈소스 진영에서 두 갈래의 거대한 기준점이 잇달아 탄생했다.
- Octo (2024.05): OXE 80만 궤적을 학습한 첫 본격 오픈소스 확산 기반 범용 정책. 다양한 카메라와 관절 공간을 블록처럼 끼워 맞출 수 있고, diffusion action head로 부드러운 행동을 뽑았다. S26
- OpenVLA (2024.06): DINOv2와 SigLIP 시각 특징을 Llama 2 기반 7B 언어 모델에 물리고, OXE 97만 시연을 학습해 가중치와 코드, LoRA 미세조정 경로까지 통째로 열었다. S07 S08
연구자들은 비로소 자기 로봇에서 실패가 났을 때 데이터 문제인지, 좌표 정규화 문제인지, 미세조정 문제인지 직접 칼을 대고 해부할 수 있게 됐다. 하지만 초기 원판 OpenVLA에는 치명적인 맹점도 숨어 있었다. RGB 이미지 한 장과 지시문만 보고 7차원 행동을 한 번에 하나씩만 내뱉었던 것이다. 과거 관측 이력도, 현재 관절 상태(proprioception)도 보지 못했다.
정지 사진 한 장만 쥐여주면 손이 컵으로 다가가다 멈춘 건지, 방금 놓치고 물러나는 중인지조차 알기 어렵다. 게다가 7B 모델이 답을 계산하는 동안 현실의 시간은 흐른다. 바로 이 1-스텝 예측의 한계를 정면으로 깨부순 두 편의 2023년 논문이 이제 역사의 전면에 올라선다.
6. ACT와 Diffusion Policy: 구간과 분포를 함께
2023년 봄, 로보틱스 학계는 두 갈래에서 동시에 “왜 한 스텝씩 예측하면 안 되는가”를 증명했다.
첫 번째 주자는 스탠퍼드의 ACT(Action Chunking with Transformers, 2023.04)였다. 모방학습 정책이 매 스텝 바로 다음 행동 하나만 예측하면, 1mm만 삐끗해도 다음 카메라 화면이 틀어지고 오차가 눈덩이처럼 불어난다. ACT는 양팔 로봇 수집 체계인 ALOHA로 모은 시연을 바탕으로, 4개 카메라 화면과 14차원 관절 상태를 보고 앞으로 H스텝 동안의 관절 목표 행렬(H × 14)을 한 번에 병렬로 뽑아냈다. S09 S10
여기에 ACT는 temporal ensembling이라는 절묘한 장치를 얹었다. 매 시점 chunk를 새로 뽑되, 같은 물리 시각 t = 12를 겨냥해 과거 여러 시점(t = 10, 11, 12)에서 내놨던 예측들을 세로로 모아 지수 가중치로 합친 것이다.
두 번째 주자는 그보다 한 달 앞서 나온 Diffusion Policy(2023.03)였다. 컵으로 다가가는데 장애물 왼쪽과 오른쪽으로 피하는 두 길이 모두 열려 있다고 치자. 이 두 궤적을 단순 평균하면 로봇 손은 장애물 한가운데를 정면으로 들이받는다. Diffusion Policy는 조건부 확산 모델(DDPM)로 행동 chunk의 다중 모달 분포 자체를 학습하고, receding-horizon 제어로 앞부분만 실행한 뒤 다시 관측하는 해법을 정립했다. S24
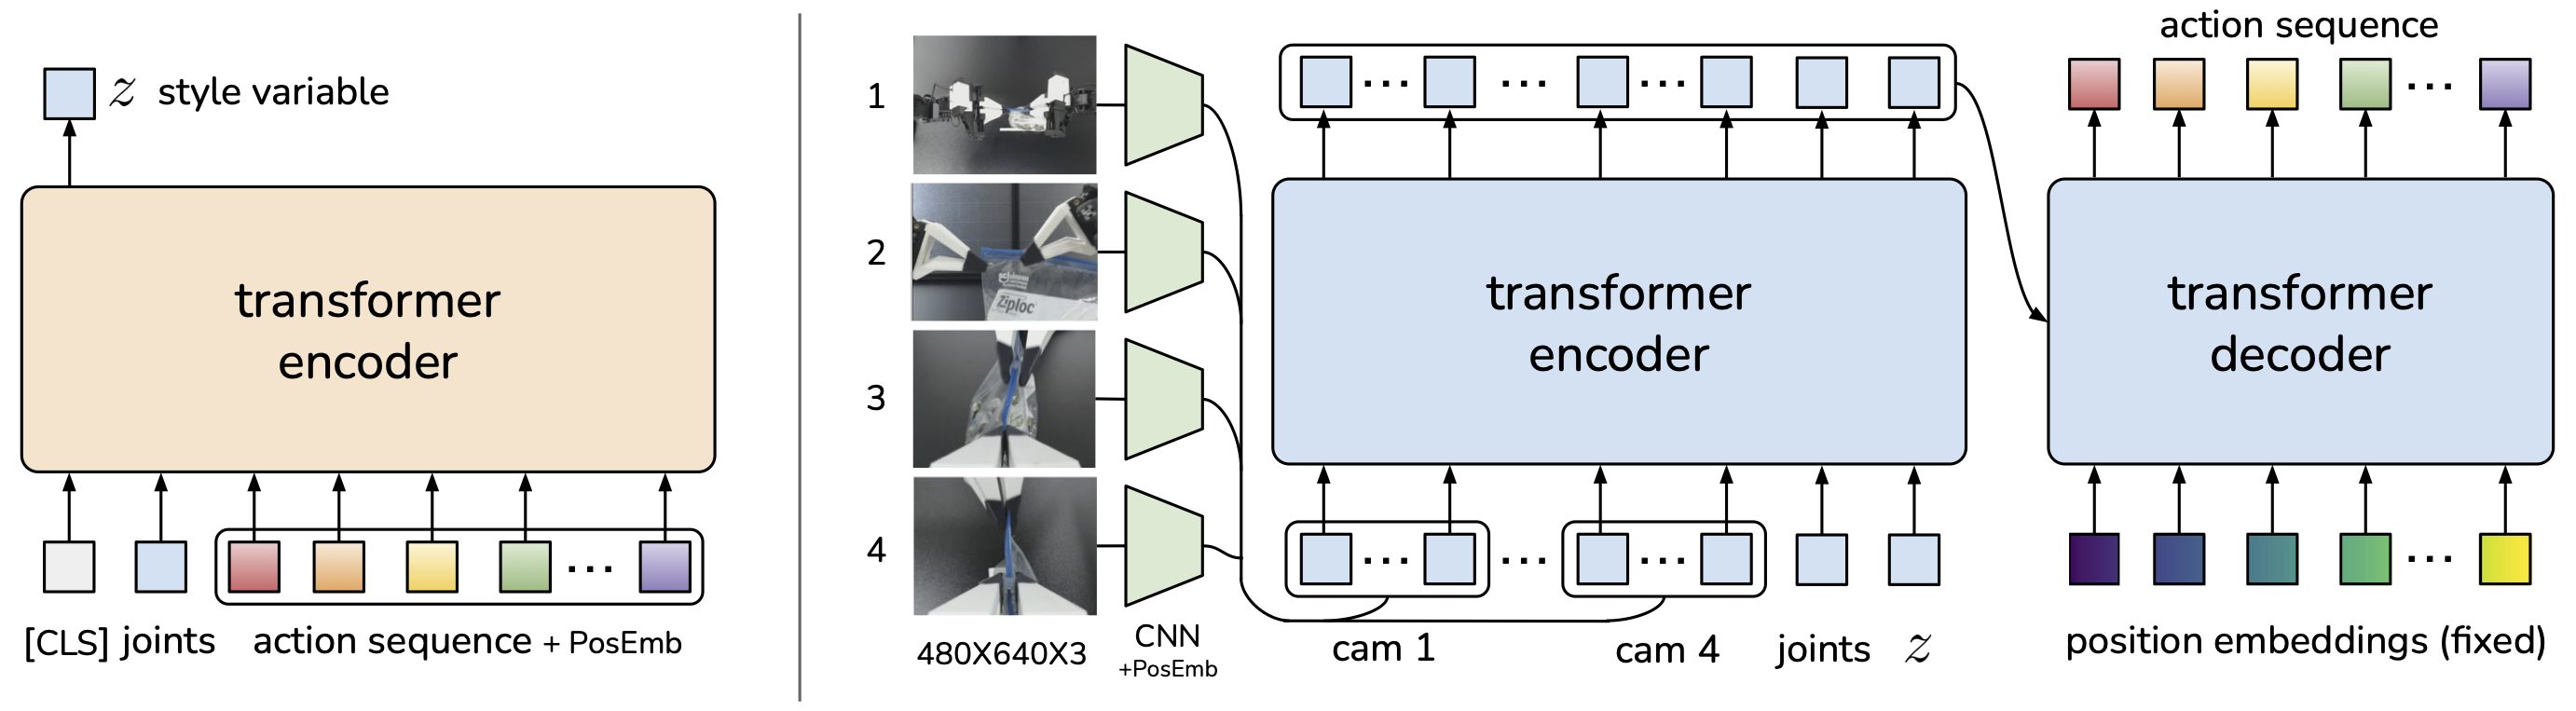

ACT의 시간축 chunking과 Diffusion Policy의 다중 모달 분포 생성이 합쳐지면서, 이후 거의 모든 현대 VLA의 행동 생성기(action head)가 이 두 기둥 위에 세워졌다.
7. 세 개의 시계: 물리·정책·생성
Chunk를 쓰기 시작하면 “로봇이 50Hz로 움직인다”는 말 한마디로는 아무것도 알 수 없게 된다. 시스템 안에서 세 개의 시계가 각자 다른 속도로 돌아가기 때문이다.
가령 로봇이 목표값을 f = 50Hz로 소비하고 정책이 H = 50개 행동을 예측하면, 한 chunk는 미래 1초 분량이다. 여기서 앞의 h = 10개만 실행하고 새 화면을 찍어 다시 묻는다면, 정책은 0.2초(5Hz)마다 한 번씩만 호출된다.
여기에 생성형 모델이 등장하면서 세 번째 시계까지 끼어들었다. Diffusion이나 Flow 모델이 chunk 하나를 빚어내기 위해 내부적으로 K = 10번 적분·디노이징을 돈다면, 이건 물리 시간과 무관한 순수 계산 스텝이다.
| 시계 | 세는 단위 | 예시 |
|---|---|---|
| 물리 행동 시계 | 로봇에 목표값 하나를 넘기는 간격 | 20ms마다 목표 1개 (50Hz) |
| 정책 갱신 시계 | 새 관측으로 chunk를 다시 뽑는 간격 | 200ms마다 새 chunk (5Hz) |
| 생성 내부 시계 | chunk 하나를 만드는 디코딩·적분 단계 | 호출 1회당 적분 10번 |
여기에 추론 지연(latency)이 0.3초까지 겹치면 로봇은 0.3초 전 옛 풍경을 보고 짠 궤적을 지금 밟게 된다. 비동기 실행으로 계산과 구동을 겹쳐 대기를 줄일 순 있지만, 이미 지나간 구간과 새 chunk를 매끄럽게 이어 붙이는 기술이 뒤따라야 한다.
예측 길이와 실행 길이
세 시계가 어떻게 맞물리는지 직접 움직여 확인하는 계산기다. 생성 반복 K를 바꿔도 물리 예측 구간은 변하지 않는다.
K = 10은 한 호출 안의 생성 계산이다. 호출 지연 100ms는 명목 실행 구간 200ms 안에 들어온다.
동기 실행에서는 대기와 지연이 더해져 실제 갱신 주기가 늘어진다. K를 바꿔도 물리 예측 구간 H/f는 그대로다.
8. System 2+1과 경량화: Helix, GR00T N1, SmolVLA
세 개의 시계가 엇갈리는 딜레마는 2025년 초 휴머노이드 VLA 전쟁에서 아키텍처의 분화를 낳았다. 무거운 VLM에게 200Hz 손가락 제어까지 떠맡기려니 계산이 도저히 따라가지 못했기 때문이다.
- Figure Helix (2025.02): 아예 뇌를 둘로 쪼갰다. 장면을 이해하고 말을 푸는 System 2(사전학습 VLM)는 7~9Hz로 천천히 돌고, 여기서 나온 잠재 표현을 받아 상반신·손가락을 움직이는 System 1(visuomotor policy)은 200Hz로 쏜다. 두 대의 휴머노이드가 서로 물건을 건네며 협업하는 데모가 여기서 나왔다. S27
- NVIDIA Isaac GR00T N1 (2025.03): System 2(VLM) + System 1(Diffusion Transformer) 이중 구조를 오픈 파운데이션 모델로 내놓으면서 데이터 피라미드까지 넓혔다. 행동 라벨이 없는 인간 영상과 합성 영상에서 잠재 행동 코드북과 역동역학 모델(IDM)로 가상 행동을 뽑아 공동학습했다. S28
- SmolVLA (2025.06): 반대로 “거대 사설 데이터와 H100 클러스터 없이도 돌릴 순 없을까?”를 물은 Hugging Face의 대안이다. LeRobot 커뮤니티 공개 데이터만으로 450M 초경량 flow-matching VLA를 학습시키고, 비동기 추론을 기본 탑재해 일반 GPU 한 장으로도 실시간 제어를 해냈다. S29

9. FAST: 행동의 알파벳을 다시 쓰다
한편 VLM의 자기회귀 문법 안에서 action chunk를 직접 뱉으려던 진영은 여전히 토큰 길이의 벽에 막혀 있었다. H = 50, d = 14인 행렬만 해도 숫자 700개다. 20ms 간격의 부드러운 궤적은 앞뒤 숫자가 거의 똑같은데도 스텝마다 토큰으로 풀려니 출력이 너무 길어졌다.
2025년 1월 공개된 FAST(Frequency-space Action Sequence Tokenization)는 JPEG 이미지 압축에서 영감을 얻어 행동의 알파벳을 갈아엎었다. 시간축에 DCT(이산 코사인 변환)를 걸어 궤적을 주파수 성분으로 바꾼 뒤, 양자화와 BPE 압축을 거쳐 단 30~60개 토큰으로 꾹 눌러 담은 것이다. S11
추론 때는 정책이 압축 토큰 몇 개만 뱉으면 역변환이 순식간에 H × d 행렬로 펼쳐 준다. 약 10배 압축을 통해 비교 조건에서 학습 속도를 최대 5배까지 끌어올렸다. S12
10. π0: Flow Matching으로 연속 궤적을 빚다
FAST보다 석 달 앞선 2024년 10월, Physical Intelligence가 내놓은 π0는 이산 토큰 대신 연속 공간에서 궤적 분포를 통째로 조각하는 길을 열었다. 3B PaliGemma VLM과 약 300M 규모의 flow-matching action expert를 attention으로 깊게 엮은 것이다. S13
무작위 가우시안 노이즈 ε에서 정답 행동 chunk A*로 건너가는 직선 경로를 설정하고,
모델 vθ가 매 내부 시간 τ ∈ [0, 1]마다 정답을 향한 속도장(A* − ε)을 맞히도록 학습한다.
실전 추론에서는 노이즈에서 출발해 학습된 속도장을 따라 10번(Euler 적분)만 걸어 나가면 H = 50 길이의 매끄러운 연속 행동 행렬이 한 번에 빚어진다.
중요한 건 내부 적분 축 τ가 물리 시간 t와 무관하다는 점이다. 10번 적분하는 동안 로봇이 움직이는 게 아니라, 미래 50스텝짜리 행렬 전체가 동시에 노이즈에서 궤적으로 피어난다.
11. π0.5: 실험실을 나와 낯선 집으로
π0는 세탁물을 개고 식탁을 치우는 화려한 손기술을 뽐냈지만, 다음 질문이 곧바로 날아들었다. “연구실 책상 위에서 잘하던 로봇을 처음 들어간 남의 집 주방에 세워놓으면 어떻게 될까?”
낯선 집에서는 조명과 컵 모양만 다른 게 아니다. ‘이 집에서 어떤 물건을 어디에 치워야 자연스러운가’라는 의미적 판단이 손놀림과 동시에 필요해진다. 2025년 4월 공개된 π0.5는 여러 로봇의 행동 데이터와 웹 시각·언어 데이터, 그리고 의미적 하위 작업(subtask) 라벨을 한 솥에 넣고 공동학습했다. S15 S16
사전학습에선 FAST 이산 토큰으로 빠르게 지식을 흡수하고, post-training 단계에서 연속 flow expert를 붙여 손끝의 정밀함을 살렸다. 추론 땐 모델이 먼저 “컵을 선반으로 옮기기” 같은 하위 작업을 텍스트로 뱉고, 이를 조건으로 삼아 연속 행동 chunk를 뽑아낸다. 한 모델 안에서 의미 판단과 운동 제어가 서로 다른 호흡으로 맞물려 돌아가기 시작한 순간이었다.
12. π*0.6과 RECAP: 실패와 교정에서 배우는 VLA
하지만 시연 데이터만 모방(Behavioral Cloning)하는 방식엔 뚜렷한 천장이 있었다. 사람 원격조작 시연은 완벽해 보여도, 막상 자율 주행을 돌리면 로봇이 미묘하게 실수하고 그 실수에서 빠져나오는 법을 몰랐다. 게다가 잘하는 시연만 모으려니 속도와 성공률 모두 한계에 부딪혔다.
2025년 11월 공개된 π*0.6과 RECAP(RL with Experience and Corrections via Advantage-conditioned Policies)은 모방학습의 벽을 강화학습(RL)으로 뚫었다. S30 기존 시연뿐만 아니라 로봇이 혼자 돌다 실패한 자율 롤아웃, 그리고 위험할 때 사람이 원격으로 끼어들어 고쳐준 개입 데이터까지 전부 모은 뒤, 가치 함수(value function)로 각 행동의 이득(advantage)을 계산해 이진 꼬리표로 붙였다.
정책을 직접 policy gradient로 흔드는 대신 advantage를 조건 입력으로 넣어 학습시켰기 때문에, 추론 땐 “높은 advantage” 조건만 걸어주면 가장 빠르고 실수 없는 행동만 뽑아낸다. 그 결과 에스프레소 머신 다루기나 공장 박스 조립 같은 고난도 작업에서 처리량은 2배 이상 뛰고 실패율은 절반 이하로 떨어졌다. S30
13. π0.7: 잡음 속에서 맥락을 건지다
π*0.6이 ‘성공 확률의 높고 낮음’을 조건으로 걸어 RL을 풀었다면, 2026년 4월 나온 π0.7(5B 규모: Gemma3 4B VLM + MEM 영상 이력 + 860M flow expert)은 이 아이디어를 전방위적 맥락 조건화(multimodal context conditioning)로 확장했다. S17 S18
같은 “컵을 치워줘”라는 지시 아래 재빠른 시연, 조심스럽게 느린 시연, 실패한 시연이 뒤섞여 있을 때, 작업 지시문뿐만 아니라 수행 품질, 속도 전략, 제어 모드, 심지어 월드 모델이 비동기로 던져주는 목표 상태 이미지(visual subgoal)까지 전부 조건으로 걸어버린 것이다.
| 실행 | 관찰된 움직임 | 꼬리표 없이 섞었을 때 | 붙일 수 있는 맥락 조건 |
|---|---|---|---|
| A | 빠르고 정확하게 놓음 | 다른 실행과 섞여 희석됨 | 높은 품질, 짧은 수행 길이 |
| B | 조심스럽게 느리게 놓음 | 어느 속도를 따라야 할지 모호함 | 신중·저속 전략 |
| C | 잘못 잡고 떨어뜨림 | 실패 패턴까지 정답처럼 학습할 위험 | 낮은 품질, 실패 연관 메타데이터 |
이렇게 꼬리표를 달아 학습해 두면, 실패한 데이터까지 거름으로 쓰되 실전 추론 땐 “높은 품질, 빠른 전략” 조건만 켜서 깔끔한 행동만 건져 올릴 수 있다. 말로 설명하기 모호한 “컵을 적당한 자리에 둬” 같은 배치 의도는 목표 이미지 한 장으로 똑 부러지게 넘겨줄 수도 있다.
14. Astra: 범용 VLM의 세 가지 역할
2022년 RT-1부터 2026년 π0.7까지, 로봇 학습의 주류는 “로봇 전용 행동 데이터를 막대하게 모아 전용 정책(VLA)을 깎는다”는 믿음 위에 서 있었다. 그런데 2026년 가을, 전혀 다른 쪽에서 균열이 생겼다. 로봇 행동 데이터로 따로 미세조정하지 않은(frozen) 범용 프론티어 VLM, 즉 GPT-6 Astra가 직접 로봇 제어 벤치마크에 뛰어든 것이다.
범용 VLM이 로봇 제어에서 맡는 역할은 크게 세 가지로 나뉜다.
Planner·supervisor(예: Gemini Robotics-ER 1.6 S23)나 Controller author(예: RoboDojo의 피아노 제어 코드 생성 S20)는 이전의 계층적 접근을 계승한다. 진짜 충격을 준 건 Direct policy였다. 카메라 화면, 현재 손 위치, 좌표계 설명만 프롬프트로 쥐여줬을 뿐인데, VLM이 매 턴 손끝이 가야 할 3차원 EEF 목표 좌표를 직접 찍어내 폐루프로 컵을 집어 올리기 시작한 것이다.
| 호출 | 입력 | 모델이 내놓는 결정 | 실행 후 새로 보는 장면 |
|---|---|---|---|
| 1 | 현재 RGB, 손 위치, 좌표계 정보, 지시 | 컵 위로 접근할 EEF 목표 | 실제 손과 컵의 상대 거리 |
| 2 | 새 RGB, 실제 도달 상태, 직전 행동·결과 | 접근 오차를 보정할 EEF 목표 | 그리퍼가 컵에 정렬됐는지 |
| 3 | 갱신된 관측·이력 | 파지 및 들어올리기 목표 | 컵이 실제로 들렸는지 |
| 4 | 이동 후 관측·이력 | 선반 위 배치 목표 또는 재시도 | 작업 완료 여부 |
No-CoT와 제어 지연의 함정
OpenAI 시스템 카드에 reasoning=None 조건에서도 꽤 많은 일을 해낸다는 관찰이 실리면서 S19 “이제 VLM이 생각 없이도 고속 제어를 한다”는 성급한 해석이 돌기도 했다. 하지만 해당 설정은 미공개일 뿐더러, 뒤이어 나온 Astranomy의 호성적 역시 medium reasoning을 켠 상태에서 얻은 결과다. S21 추론문을 생략할 수 있다는 것과 로봇이 실시간 고주파로 안정적으로 움직인다는 건 전혀 다른 문제다.
15. 신기루 걷어내기: 성공률 뒤의 조건들
2026년 9~10월에 쏟아진 세 편의 Astra 평가 논문은 겉보기 성공률만 보면 극과 극을 달린다. 하지만 조건을 한 꺼풀씩 벗겨보면 비로소 진짜 그림이 드러난다.
| 사례 | 보고된 결과 | 반드시 함께 볼 조건 | 해석의 초점 |
|---|---|---|---|
| RoboDojo, 2026-09 | 42개 task·2,100회 시뮬레이션 평균 SR 22.48% | frozen VLM의 수치 EEF 제어; 정밀·동적·양팔 과제에서 약세 | 의미 이해와 물리 제어 사이의 간극 |
| Astranomy, 2026-10 | RoboLab-120에서 Direct 66.3%, Agentic 74.8%, Orchestrated 66.5% | task당 5회 평가; 추론 중 시뮬레이터 정지 | 인터페이스·이력·연산 예산의 기여 |
| RoboMME Astra 연구, 2026-10 | 16개 기억 과제·800회 시뮬레이션 SR 92.1% | 전체 에피소드 context, EEF waypoint, 벤치마크 motion planner 사용 | 기억 효과와 행동 인터페이스 효과 분리 |
세 연구는 시험 환경이 달라 수평 비교가 불가능하다. RoboDojo는 실물 로봇 평가 도중 위험한 명령과 장비 파손이 발생해 공식 평가를 중단했다. S20 Astranomy는 높은 성공률을 냈지만, 성공 에피소드 기준 호출당 18.56초가 걸렸고 Agentic 모드는 에피소드당 3,090만 토큰($36.40)을 태웠다. 무엇보다 모델이 생각하는 동안 시뮬레이터 시간을 정지시켜 두었기 때문에, 현실처럼 시간이 흐르는 동적 환경에서의 반응성까지 입증하진 못했다. S21
RoboMME 역시 92.1%라는 압도적 수치를 보였지만, Astra 쪽엔 전체 에피소드 이력과 EEF waypoint, 벤치마크 motion planner를 쥐여준 반면 비교군 학습 정책들은 관절 공간 행동을 썼다. 게다가 프롬프트와 프레임 밀도를 튜닝할 때 test split을 참조했다. S22
그럼에도 이 결과들이 남긴 교훈은 묵직하다. 이제 로봇 제어의 성패를 가르는 건 모델 가중치 하나가 아니다. 좌표계 설명, 시간 이력, 도구 인터페이스, 그리고 아래단 실행기의 성능이 합쳐져 점수를 만든다.
16. Decision Model: 문장을 버리고 선택지만 채점하다
15장에서 확인했듯 GPT-6 Astra 같은 거대 VLM은 시뮬레이터를 세워두고 고민하면 놀라운 판단을 내리지만, 매 제어 턴마다 텍스트와 추론문을 읊느라 수십 초와 수십 달러를 태운다. 그런데 로봇이 “지금 컵을 잡았나?”, “다음엔 1번 스킬과 2번 스킬 중 무엇을 부를까?”를 결정할 때 정말 수백 단어짜리 문장이 필요할까?
2026년 10~11월, 바로 이 물음에서 Decision Model(의사결정 전용 모델)이라는 새 범주가 급부상했다. 구글의 Gemini Decision 1(Decisions API, 2026.11) S31, Liquid AI의 옴니모달 d1 / d1.2 S32, TypeSafe AI의 Jev S33, Perplexity의 pplx-decider-flash가 대표적이다. 이들의 문법은 단순하다. 자유 텍스트 생성을 아예 포기하는 대신, 텍스트·이미지·오디오 입력을 보고 미리 정해진 후보 선택지들에 대해 보정된 확률(calibrated probability)만 병렬로 뱉는다.
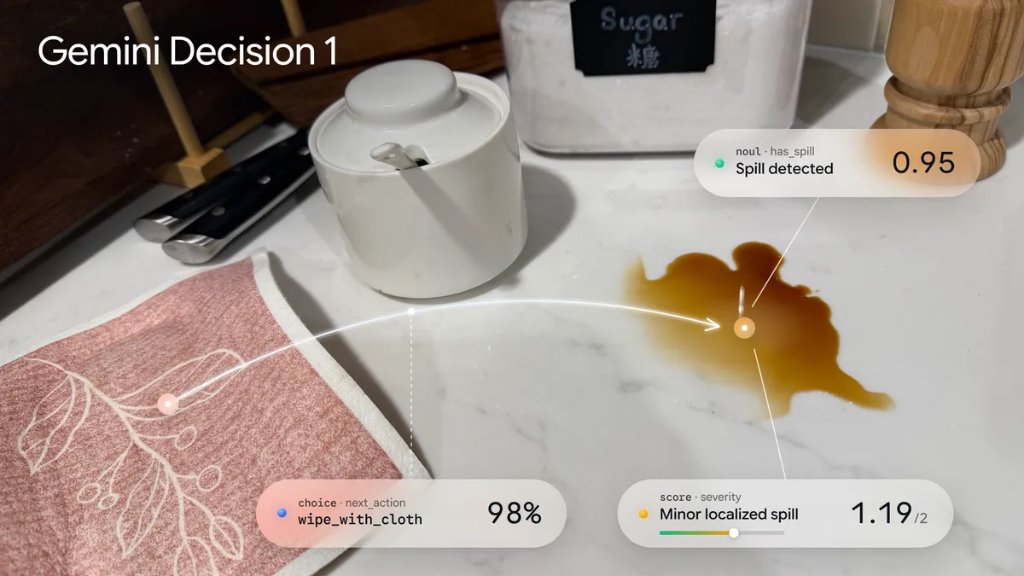
has_spill: 0.95), 연속 점수(severity: 1.19/2), 다음 행동 선택지(wipe_with_cloth: 98%)만 보정된 확률로 출력하는 모습 (공식 발표 보기 ↗).로봇 지능의 계보에서 보면, Decision Model은 2022년 SayCan의 직계 후손이자 Track 1의 초고속 분화다. SayCan이 후보 스킬마다 성공 가능성 점수를 매겼듯, Decision Model은 System 2 계층에 들어가 Astra의 18초짜리 병목을 밀리초~수백 밀리초 단위로 압축하며 세 가지 핵심 역할을 맡는다.
- 초고속 상위 플래너(Planner): 현재 장면과 지시를 보고 다음에 실행할 서브태스크를 고정 선택지 확률(예:
pick: 0.88,retry: 0.09,stop: 0.03)로 즉각 채점한다. - 성공 검증기(Verifier): 동작 직후 카메라 장면을 받아 물체 파지나 배치가 성공했는지 보정된 확률로 즉시 판정한다.
- 실시간 라우터(Router) & Track 3와의 분업: 상위 층위의 Decision Model이 밀리초 단위로 목표와 분기를 라우팅해 넘기면, 하위 층위의 Flow-Matching VLA(
π0,π0.7등)가 10회 안팎의 오일러 적분으로 미래 H=50 스텝 분량의 연속 궤적(Action Chunk)을 빚어내고 저수준 제어기가 50~200Hz로 실행한다.
물론 경계선은 분명히 그어야 한다. Decision Model은 이산적 선택과 판정에 특화된 모델이지, π0나 Diffusion Policy처럼 50~200Hz의 연속 손끝 궤적을 직접 빚어내는 물리 제어기가 아니다. 또한 강화학습의 옛 Decision Transformer나 미래 영상과 행동을 함께 생성하는 World Action Model(예: DreamZero)과도 이름만 비슷할 뿐 전혀 다른 계열이다.
17. 공정한 비교를 위한 실험 설계
컵을 못 찾는 실패, 집다 놓치는 실패, 치운 컵을 또 집는 실패를 전부 “VLA의 실패”로 뭉뚱그리면 아무것도 고칠 수 없다. “범용 VLM이 VLA를 대체했다”고 말하려면, 정확히 어느 블록을 갈아 끼웠는지부터 못 박아야 한다.
| 비교 축 | 반드시 맞추거나 기록할 요소 | 빠뜨렸을 때 생기는 착시 |
|---|---|---|
| 과제·split | task, 물체, 환경, seed, unseen 조건 | 쉬운 환경 차이를 모델 실력으로 착각 |
| 관측 | 카메라 수, state, calibration, 이력, 기억 | 더 많이 보여준 걸 더 똑똑한 추론으로 착각 |
| 행동·실행기 | skill/EEF/joint, IK, motion planner, 추종기 | 실행기가 다 해준 걸 모델 능력으로 착각 |
| 시간 | 호출 지연, 실행 길이, 재관측 주기, 시뮬 정지 여부 | 시간 멈춘 세계의 성공을 실시간 반응성으로 착각 |
| 적응 | 로봇 fine-tuning, 프롬프트 튜닝, 시연, 반복 시험 | frozen weights를 개발 과정 전체의 무적응으로 착각 |
| 결과·비용 | SR, 실제 완료 시간, 개입 횟수, 접촉 실패, API 비용 | 수십 초·수십 달러짜리 성공을 실전 배포 성능으로 착각 |
이 틀을 쥐고 실험실로 돌아가면 당장 던져볼 수 있는 세 가지 검증 실험이 나온다.
첫째, 기억의 효과 분리. VLM과 실행기를 고정한 채 현재 1장, 짧은 이력, 전체 이력, 요약 기억을 맞붙여 가림 뒤 물체 위치 추적과 반복 횟수 과제를 시험한다.
둘째, 행동 인터페이스의 공정 비교. 같은 관측에서 EEF waypoint와 관절 목표를 비교한다. VLM의 우위가 고성능 motion planner를 붙인 EEF에서만 나온다면 그건 인터페이스 궁합의 공이다.
셋째, 지연의 비용 측정. 같은 정책에 인위적 지연을 걸고 시뮬레이터 정지 옵션을 켰다 껐다 하며 정적·동적 물체를 시험해, 지연이 실패로 번지는 고리를 정량화한다. 같은 잣대는 내비게이션(VLN)에서 후보 노드, waypoint, 선·각속도(v, ω) 중 무엇을 뱉는지 따질 때도 그대로 통한다.
18. 한눈에 보는 로봇 정책의 설계 지도
지금까지 지나온 연구들은 구형을 신형이 몰아낸 단선적 역사가 아니다. 로봇 정책이라는 거대한 설계 공간에서 저마다 다른 질문을 파고든 좌표들이다.
| 연구 | 던진 핵심 질문 | 대표 출력·역할 | 섞어 읽지 말아야 할 점 |
|---|---|---|---|
| SayPlan | 거대한 공간에서 계획을 접지시킬 수 있나? | 그래프 검색, 상징 계획 | 운동 정책이 아니라 상위 계획 계층 |
| RT-1 | 여러 지시의 행동을 한 정책에 담을 수 있나? | 시점별 수치 행동 토큰 | 256 bin은 완성 스킬 ID가 아님 |
| RT-2 | 웹의 의미 지식을 행동 선택으로 옮길 수 있나? | VLM의 행동 토큰 | 의미 일반화와 새 손기술은 별개 |
| OXE / RT-X | 남의 로봇 경험이 내 로봇을 도울 수 있나? | 22종 로봇 데이터 통합 | 단일 아키텍처가 아닌 데이터 표준 |
| Octo / OpenVLA | 공개 데이터로 범용 정책을 뜯어고칠 수 있나? | Diffusion / 7B 1-스텝 행동 | 원판과 후속(OFT 등) 스펙 구분 |
| ACT / Diffusion Policy | 시간 구간과 다중 모달 분포를 어떻게 배울까? | 병렬 chunk / DDPM 궤적 | 대다수 현대 VLA action head의 원조 |
| Helix / GR00T N1 | 느린 VLM과 빠른 제어기를 어떻게 공존시킬까? | System 2(VLM) + System 1(200Hz) | 고정밀 휴머노이드 전신·이중 속도 |
| SmolVLA | 개인 GPU 한 장으로 실시간 VLA가 될까? | 450M 경량 + 비동기 추론 | 커뮤니티 데이터만 사용한 효율화 |
| FAST | 행동 시퀀스를 어떤 토큰으로 압축할까? | DCT+BPE 압축 토큰 | 토크나이저 자체는 정책이 아님 |
| π0 / π0.5 | 연속 분포와 낯선 집 일반화를 어떻게 잇나? | Flow chunk / Subtask+Flow | 내부 적분 스텝과 물리 시간 구분 |
| π*0.6 (RECAP) | 모방학습의 천장을 RL로 어떻게 뚫을까? | Advantage 조건화 행동 | 자율 실패와 사람 교정까지 학습 |
| π0.7 | 품질·전략이 뒤섞인 데이터를 어떻게 쓸까? | Context로 제어되는 행동 | 기술 조합과 미학습 새 기술 구분 |
| Astra 흐름 | 범용 VLM을 어디까지 정책으로 쓸 수 있나? | waypoint, 감독, 제어 코드 | 인터페이스·기억·추론 비용 함께 확인 |
| Decision Model | 문장 생성 없이 선택지 채점만으로 속도와 비용을 잡을까? | 고정 선택지 보정 확률 | Planner·Verifier 계열이지 연속 궤적 제어기가 아님 |
내일 또 새로운 이름의 로봇 모델이 쏟아져 나와도 당황할 필요는 없다. 모델 이름과 파라미터 크기보다 먼저 이 네 가지를 물으면 역사의 맥락 속에서 그 모델의 자리가 바로 잡힌다.
이 시스템은 무엇을 보고, 무엇을 결정하며, 어느 구성요소가 그걸 실행하고, 얼마나 움직인 뒤 결과를 다시 보는가.
19. 역사의 회귀: 네 트랙이 만나는 곳
이제 연대기의 끝에서 다시 그림 0의 세로축(Track 1–4)으로 시선을 돌려보자. 시간순으로 따라올 땐 새 모델이 옛 모델을 밀어내는 것처럼 보이지만, 트랙별로 묶어 보면 놀라운 역사의 회귀와 수렴이 포착된다.
Track 1의 나선형 회귀: 외곽 지휘에서 직접 제어, 그리고 초고속 채점으로
2022–2023년의 SayCan과 SayPlan은 거대 모델에게 “무엇을 할지 계획만 짜고, 실제 움직임은 고전 스킬에 넘기라”고 선을 그었다. 그로부터 3년 뒤 등장한 GPT-6 Astra의 Direct Policy는 정반대로 범용 VLM이 직접 3D EEF 좌표를 찍어내는 듯 보인다. 언뜻 원점으로 돌아간 것 같지만, 나선형으로 한 바퀴 올라선 회귀다. 과거 LLM이 텍스트 그래프만 만졌다면, 2026년의 VLM은 전체 에피소드 시각 이력을 쥐고 IK와 motion planner를 도구처럼 부리며 직접 수치 공간에 개입한다. 동시에 그 18초짜리 지연과 비용의 반작용으로, 문장 생성을 버리고 SayCan처럼 선택지 확률만 초고속으로 채점하는 Decision Model이 2026년 말 다시 전면에 등장하며 Track 1의 또 한 번의 회귀를 완성했다.
Track 2와 Track 3의 화해: 이산 토큰과 연속 분포의 분업
RT-1·RT-2가 연 이산 토큰 방식(Track 2)과 Diffusion Policy·ACT·π0가 연 연속 분포 방식(Track 3)은 오랫동안 “어느 쪽이 행동 표현의 정답인가”를 두고 맞섰다. 하지만 역사는 둘 중 하나를 고르는 대신 단계별 분업으로 답을 냈다. π0.5는 사전학습에선 FAST 이산 토큰으로 압도적 속도를 챙기고, 실전 제어에선 flow matching 연속 전문가로 손끝의 정밀함을 살렸다. 표현의 싸움이 파이프라인 내부의 협업으로 수렴한 셈이다.
Track 4가 드러낸 진실: 데이터 크기 다음은 ‘구조화된 맥락’
OXE 이후 한동안은 “데이터를 더 많이 긁어모으면 된다”는 스케일링 믿음이 지배했다. 그러나 π*0.6(RECAP)과 π0.7은 양보다 중요한 게 경험의 질과 꼬리표임을 증명했다. 실패한 자율 주행, 느린 시연, 빠른 시연을 무작정 섞으면 정책이 흐려지지만, advantage와 품질·속도·visual subgoal을 맥락 조건으로 걸어주면 버릴 데이터가 하나도 남지 않는다.
2026년 이후: 네 트랙이 수렴하는 하나의 아키텍처
결국 출발점은 넷이었지만, 2026년 말 시점에서 최전선의 로봇 지능은 한 지점으로 모여들고 있다. 네 트랙의 성과가 하나의 시스템 내부에서 서로 다른 시간축과 역할을 나눠 맡는 구조다.
- Track 1 (상위 추론 & Decision Model): 범용 VLM이 전체적인 의미 맥락과 상식을 해석하고, Decision Model이 지연 없이 초고속으로 상위 목표와 서브태스크 분기를 라우팅한다.
- Track 2 (행동 토큰 압축): 사전학습 단계나 시퀀스 처리에서
FAST의 주파수 기반 압축(DCT+BPE)을 활용해 이종 로봇 데이터를 콤팩트하게 소화한다. - Track 3 (연속 분포 & Flow Matching):
Action Chunking과 플로우 매칭 Action Expert가 다중 모달 분포를 깨지 않고 부드러운 고주파 물리 궤적을 생성한다. - Track 4 (강화학습 이득 & 맥락 조건화):
π*0.6(RECAP)의 이득 함수와π0.7의 멀티모달 맥락 조건화(품질·속도·시각적 하위 목표)가 실패 경험을 거름 삼아 최적의 전략과 손놀림만 실시간으로 조향한다.
특히 Decision Model은 Astra가 드러낸 ‘지연과 비용의 병목’을 뚫어냄으로써, 상위 인지 모델(Track 1)이 고주파 연속 물리 제어 모델(Track 3)과 실시간으로 매끄럽게 호흡을 맞출 수 있는 결정적 연결고리로 자리 잡았다.
실제로 2025년 하반기부터 2026년에 걸쳐 등장한 최신 통합 시스템 논문·아키텍처들은 이 네 트랙이 더 이상 추상적 청사진이 아니라 하나의 작동하는 파이프라인으로 결합했음을 보여준다.
- Figure AI · Helix 02 (2026.01):
System 2(VLM 상위 추론, Track 1) +System 1(200Hz 비전·촉각 연속 행동 정책, Track 3) 아래에 인간 모션과 강화학습으로 배운 1kHz 전신 균형 프라이어 System 0(Track 4)을 깔아, 기존 C++ 제어 코드 10만 줄을 통째로 신경망 계층으로 대체하고 4분 연속 식기세척기 작업까지 완수했다. - HAF · HAF-VLA & HAF-Steer (2026.08): 사전학습된 Flow-Matching VLA 백본(Track 3)은 얼려둔 채, DCT 주파수·노이즈 잠재 공간(Track 2) 위에서 오프라인→온라인 RL(
HAF-Steer, Track 4)로 전신 휴머노이드를 안전하게 조향하는 계층형 결합을 선보였다. - Google DeepMind · Gemini Robotics 1.5 (2025.09): 행동 전 자연어로 단계별 공간 추론과 도구 호출을 수행하는 Embodied Reasoning(Track 1)과 이종 로봇 간 연속 행동 생성(Track 2·3)을 클라우드–온디바이스 이중 구조로 통합했다.
- NVIDIA GR00T 2 (2026): 미래 시각 예측과 연속 행동을 함께 빚는 World-Action Model(Track 3)에 실세계 RL 적응(Track 4)과 교차 로봇 전이를 결합한 통합 파운데이션 시스템을 제시했다.
이처럼 최전선의 시스템 논문들은 네 트랙을 각기 다른 시간축과 추상화 층위에 배치해 하나의 몸으로 엮고 있다. 앞으로 나올 어떤 논문도 이 네 트랙 중 어느 층위를 찌르고 있는지, 혹은 어느 층위들을 어떻게 이어 붙였는지 가늠하면 그 무게를 정확히 재볼 수 있다.
부록 A. 전체 연표
본문은 문제의 흐름을 따라 배치했으므로, 실제 발표 연대순과 헷갈리지 않게 전체 17개 마일스톤을 연표로 묶었다.
| 공개 시점 | 연구 | 발표 베뉴 | 역사적 위치 |
|---|---|---|---|
| 2022-04 | SayCan | CoRL 2022 | affordance 기반 스킬 선택 |
| 2022-12 | RT-1 | RSS 2023 (arXiv 2022.12) | 수치 행동을 직접 배우는 다작업 단일 정책 |
| 2023-03 | Diffusion Policy | RSS 2023 (IJRR 확장) | 조건부 확산 모델로 다중 모달 행동 분포 학습 |
| 2023-04 | ACT | RSS 2023 | 시간축 행동 묶음(chunking)과 앙상블 |
| 2023-07 | SayPlan | CoRL 2023 | 3D scene graph 기반 고수준 계획·검증 |
| 2023-07 | RT-2 | CoRL 2023 | 웹 사전학습 지식과 행동 토큰의 결합 |
| 2023-10 | Open X-Embodiment | ICRA 2024 (Best Paper) | 22종 로봇 데이터 통합 및 교차 전이 입증 |
| 2024-05 | Octo | RSS 2024 | OXE 기반 첫 오픈소스 확산 범용 정책 |
| 2024-06 | OpenVLA | CoRL 2024 | 7B 공개 가중치와 새 로봇 적응의 출발점 |
| 2024-10-31 | π0 | RSS 2025 (arXiv 2024.10) | 연속 flow-matching 행동 생성 |
| 2025-01-16 | FAST | RSS 2025 | 주파수 기반 행동 시퀀스 토큰화 |
| 2025-02~03 | Helix · GR00T N1 | Figure AI 공식 발표 · NVIDIA 기술 보고서 (arXiv) | System 2(VLM) + System 1(200Hz) 이중 구조 |
| 2025-04-22 | π0.5 | CoRL 2025 | 이종 데이터 공동학습과 낯선 집 일반화 |
| 2025-06 | SmolVLA | arXiv · Hugging Face 기술 보고서 | 450M 경량 VLA 및 비동기 추론 |
| 2025-11 | π*0.6 + RECAP | arXiv · Physical Intelligence 기술 보고서 | 오프라인/온라인 RL과 advantage 조건화 |
| 2026-04-16 | π0.7 | Physical Intelligence 공식 발표 · 기술 보고서 | 전방위적 멀티모달 context conditioning |
| 2026-09~10 | Astra 로봇 평가 연구들 | OpenAI System Card · arXiv / NVIDIA Research | frozen VLM의 직접 정책 가능성과 한계 검증 |
| 2026-10~11 | Decision Model (Gemini Decision 1 · d1.2 · Jev) | Google · Liquid AI · TypeSafe AI 공식 발표 | 텍스트 생성을 버린 고속 멀티모달 선택·검증 모델 |
부록 B. 1차 자료와 읽을 위치 (S01–S30)
자료 기준일은 2026-11-17이다.
S01 · SayPlan — 공식 프로젝트, CoRL 논문. Semantic search, iterative re-planning, 실행기 연결 부분을 본다.
S02 · SayCan — 공식 프로젝트. 언어적 유용성과 affordance 결합을 본다.
S03 · RT-1 원논문 — RT-1: Robotics Transformer for Real-World Control at Scale. §5 입출력·토큰화와 §6 일반화 평가.
S04 · RT-1 공식 자료 — 프로젝트. 데이터 수집 규모와 3Hz 제어 루프.
S05 · RT-2 원논문 — Vision-Language-Action Models Transfer Web Knowledge to Robotic Control. §3 행동 표현·co-fine-tuning과 §5 한계.
S06 · RT-2 공식 자료 — 프로젝트. 의미 일반화 사례와 CoT 변형 실험.
S07 · OpenVLA 원논문 — An Open-Source Vision-Language-Action Model. §3과 §6에서 원판 스펙과 후속 개선(OFT 등)을 가른다.
S08 · OpenVLA 공식 자료 — 프로젝트, 코드. 모델 구조, 970k 데이터, LoRA 적응 경로.
S09 · ACT 원논문 — Learning Fine-Grained Bimanual Manipulation with Low-Cost Hardware. §IV의 chunking, temporal ensembling, CVAE.
S10 · ALOHA·ACT 공식 자료 — 프로젝트. 학습·추론 시 z 처리, 카메라 4대와 14D 관절 목표.
S11 · FAST 원논문 — Efficient Action Tokenization for Vision-Language-Action Models. §V의 DCT·양자화·BPE와 압축–복원 트레이드오프.
S12 · FAST 공식 해설 — Physical Intelligence. 토크나이저, π0-FAST, 학습 속도 향상 주장.
S13 · π0 원논문 — A Vision-Language-Action Flow Model for General Robot Control, 공식 PDF.
S14 · π0 공식 발표 — 2024-10-31. 시연 범위와 일반화 주장의 경계.
S15 · π0.5 원논문 — A Vision-Language-Action Model with Open-World Generalization.
S16 · π0.5 공식 발표 — 2025-04-22. 낯선 집 일반화 분석.
S17 · π0.7 공식 발표 — 2026-04-16. 전략 메타데이터, visual subgoal, compositional generalization.
S18 · π0.7 원논문 — A Steerable Generalist Robotic Foundation Model with Emergent Capabilities.
S19 · Astra 공식 자료 — GPT-6 Astra System Card. No-CoT 관찰과 미공개 설정 범위.
S20 · RoboDojo Astra 평가 — An Unexpected Robot Policy: Early Evaluations of GPT-6 Astra on RoboDojo and Beyond, 2026-09-21.
S21 · Astranomy — NVIDIA Seattle Robotics Lab 공식 페이지, CoRL 2026 LBR, 2026-10-14.
S22 · 기억 과제의 Astra 정책 — Can a Frontier VLM Serve as a Robot Policy for Memory-Dependent Manipulation?, v2 2026-10-16.
S23 · VLM과 행동 정책의 결합 사례 — Gemini Robotics-ER 1.6 공식 발표, 2026-04-14.
S24 · Diffusion Policy — Diffusion Policy: Visuomotor Policy Learning via Action Diffusion, 프로젝트, RSS 2023.
S25 · Open X-Embodiment & RT-X — Open X-Embodiment: Robotic Learning Datasets and RT-X Models, 프로젝트.
S26 · Octo — Octo: An Open-Source Generalist Robot Policy, 프로젝트, RSS 2024.
S27 · Figure Helix — Helix: A Vision-Language-Action Model for Generalist Humanoid Control, 2025-02-20.
S28 · NVIDIA Isaac GR00T N1 — GR00T N1: An Open Foundation Model for Generalist Humanoid Robots, 2025-03-18.
S29 · SmolVLA — SmolVLA: A Vision-Language-Action Model for Affordable and Efficient Robotics, 2025-06-02.
S30 · π*0.6 + RECAP — π*0.6: a VLA That Learns From Experience, 2025-11-18.
S31 · Gemini Decision 1 — Google Decisions API 공식 발표, 모델 문서, 2026-11-11.
S32 · Liquid AI d1 / d1.2 — Liquid Foundation Models, d1.2 옴니모달 결정 모델 분석, 2026-11-17.
S33 · TypeSafe AI Jev — Gemini 4 vs Jev — Generative LLM vs Decision Model, 2026.
부록 C. 핵심 기술 용어 사전
본문에서 점선 밑줄이 그어진 용어에 마우스를 올리면 바로 뜻이 뜨고, 클릭하면 아래 사전 항목으로 이동한다.
- 의사결정 전용 모델
- 자유 텍스트를 길게 생성하지 않고, 멀티모달 입력에 대해 미리 정한 후보 선택지들의 보정된 확률(calibrated probability)만 빠르게 채점하는 모델(예: Gemini Decision 1, d1.2, Jev).
- 보정된 확률
- 모델이 내놓은 신뢰도 점수가 실제 정답률·성공률과 통계적으로 일치하도록 보정된 확률값.
- OXE · 교차 로봇 대규모 데이터셋
- 전 세계 수십 개 연구실의 22종 이상 로봇 시연 데이터를 RLDS 표준 형식으로 통합한 대규모 오픈소스 데이터셋.
- 시간적 앙상블
- 매 시점 뽑은 겹치는 action chunk들 가운데 같은 미래 물리 시각을 겨냥한 예측값들을 지수 가중 평균으로 합쳐 궤적을 매끄럽게 만드는 기법.
- 맥락 조건화
- 작업 지시문뿐 아니라 수행 품질, 속도 전략, 제어 모드, 목표 이미지 같은 부가 정보를 조건 입력으로 넣어 모델 출력을 제어하는 기법.
- 교차 로봇 전이
- 팔 길이, 자유도, 센서 구성이 서로 다른 여러 로봇의 데이터를 함께 학습해 한 로봇의 경험을 다른 로봇으로 옮기는 기술.
- 행동 모방 (BC)
- 전문가의 시연 데이터(관측→행동)를 지도학습으로 그대로 따라 하도록 학습시키는 가장 기본적인 모방학습 방식.
- 행동 묶음 예측
- 바로 다음 1스텝만 예측하지 않고, 앞으로 이어질 H개 시점의 행동 구간을 한 번에 묶어 예측해 누적 오차를 줄이는 기법.
- 후퇴 구간 제어
- 미래 H스텝의 궤적을 통째로 계산하되 실제로는 앞의 h스텝만 실행하고, 새 관측을 받아 다시 H스텝을 새로 짜는 제어 전략.
- 3차원 장면 그래프
- 건물–층–방–물체의 공간적 위치와 상태, 관계를 계층적 그래프로 정리한 3차원 지도 표현.
- 공동 미세조정
- 로봇 행동 데이터만 단독 학습하지 않고, 기존 웹 Vision-Language 데이터를 함께 섞어 학습시켜 상식 망각을 막는 기법.
- 조건부 변분 오토인코더 (CVAE)
- 시연 데이터에 섞인 다양한 스타일을 잠재변수 z로 압축해 학습하고, 추론 땐 z=0으로 고정해 일관된 행동 구간을 뽑는 생성 구조.
- 모션 플래너
- 시작 자세에서 목표 waypoint까지 장애물과 자가 충돌을 피하는 기구학적 경로를 자동으로 계산해 주는 고전 계획기.
- 가치 함수
- 현재 상태에서 앞으로 끝까지 갔을 때 기대되는 누적 보상(성공 확률)을 추정하는 강화학습 함수.
- 시각적 하위 목표
- 말로 설명하기 모호한 공간 배치를 전달하기 위해, 앞으로 도달해야 할 목표 장면을 이미지 한 장으로 제시하는 방식.
- 플로우 매칭
- 노이즈 분포에서 목표 데이터 분포로 곧장 이동하는 속도장(vector field)을 학습해 적은 적분 스텝으로 연속 출력을 만드는 생성 기법.
- 고유수용감각 (내부 상태)
- 카메라 같은 외부 시야가 아니라, 로봇 스스로 느끼는 현재 관절 각도·속도·그리퍼 개폐 상태 등 내부 몸 상태 정보.
- 시각-언어 학습
- 이미지와 텍스트를 함께 이해하고 연결하는 멀티모달 표현 학습.
- 시각-운동 제어
- 카메라 시각 입력을 받아 로봇의 관절·모터 움직임으로 직접 연결하는 제어 방식.
- 토큰 러너
- 이미지의 수많은 공간 패치 토큰 중 중요한 소수(예: 8개)만 어텐션으로 뽑아내 연산량을 크게 줄이는 압축 모듈.
- 에피션트넷
- 해상도·깊이·너비를 균형 있게 키워 적은 연산으로도 높은 시각 특징 추출 성능을 내는 합성곱 신경망(CNN).
- 트랜스포머
- 어텐션(Attention) 메커니즘으로 입력 시퀀스 요소들 사이의 관계를 한꺼번에 파악하는 딥러닝 핵심 구조.
- 어포던스 (행동 가능성)
- 현재 환경과 물체 상태에서 특정 동작(예: 문 열기, 컵 집기)이 물리적으로 성공할 수 있는 가능성.
- 이득 함수 (Advantage)
- 어떤 상태에서 특정 행동을 택했을 때, 평균 기대치보다 최종 성공·보상이 얼마나 더 좋아지는지를 나타내는 강화학습 지표.
- 후속 학습
- 대규모 사전학습(pre-training)된 범용 모델을 특정 로봇이나 고난도 작업에 맞춰 정밀하게 다듬는 추가 학습 단계.
- 미세조정
- 사전학습된 모델의 가중치를 특정 도메인이나 새 로봇 데이터에 맞게 추가로 업데이트하는 과정.
- Semantic Generalization
- 학습 때 못 본 새 물체나 표현을 웹 상식과 연결해 ‘무엇을 해야 할지’ 알아맞히는 능력.
- Motion Generalization
- 학습 시연에 없던 낯선 접촉 조건, 속도, 역학 환경에서도 ‘새로운 손놀림’을 해내는 능력.
- Multimodal Distribution
- 한 상황에서 유효한 정답이 여러 갈래(예: 왼쪽 회피 vs 오른쪽 회피)로 갈라져 봉우리가 여러 개인 확률 분포.
- Asynchronous Inference
- 로봇이 현재 chunk를 실행하는 동안 백그라운드에서 다음 chunk를 미리 계산해 대기 시간을 감추는 실행 방식.
- Inverse Dynamics Model (IDM)
- 연속된 두 영상 프레임만 보고 그사이에 어떤 행동이 일어났는지 역으로 추론해 행동 라벨을 붙여주는 모델.
- 오일러 적분
- 학습된 속도장(미분방정식)을 작은 시간 간격 Δτ만큼 반복해 더함으로써 노이즈를 실제 행동 궤적으로 펴내는 수치 적분법.
- Autoregressive 생성
- 시퀀스의 이전 토큰들을 조건으로 삼아 다음 토큰을 한 번에 하나씩 순차적으로 생성하는 방식.
- Discretization
- 연속적인 실수 값을 일정 개수의 구간(bin)으로 쪼개 정수 번호로 바꾸는 과정.
- Quantization
- 연속 실수나 고해상도 수치를 정해진 개수의 이산 눈금(bin)으로 근사해 표현하는 기법.
- Closed-loop 제어
- 한 번 명령을 내리고 끝내는 게 아니라, 매 순간 센서로 결과를 다시 관측해 다음 행동을 수정하는 피드백 제어 방식.
- 경유점 (Waypoint)
- 로봇 말단(EEF)이나 이동 로봇이 거쳐 가야 할 공간상의 목표 위치·자세 좌표.
- System 2 (느린 추론)
- 느리지만(7~9Hz) 카메라 장면과 자연어 지시를 깊이 해석하는 상위 VLM 추론 모듈(이중 과정 이론에서 차용).
- System 1 (초고속 제어)
- 빠르고(200Hz) 반사적으로 관절·손가락의 실시간 모터 명령을 생성하는 하위 제어 정책.
- 다익스트라 알고리즘
- 그래프 위에서 두 지점 사이의 최단 이동 경로를 찾는 고전 탐색 알고리즘.
- DINOv2 비전 인코더
- 자기지도학습으로 물체의 기하학적 구조와 경계를 정밀하게 잡아내는 메타(Meta)의 비전 인코더.
- SigLIP 비전-언어 인코더
- 이미지와 텍스트 쌍을 시그모이드 대조 학습해 의미적 연결에 강한 시각 특징을 뽑아내는 인코더.
- Llama 2 언어 모델
- 메타(Meta)가 공개한 오픈소스 거대 언어 모델 백본.
- Low-Rank Adaptation
- 거대 모델의 원래 가중치는 얼려두고 작은 저랭크 행렬만 추가 학습해 적은 VRAM으로 빠르게 미세조정하는 기법.
- RL Datasets 포맷
- 로봇 에피소드의 관측·행동·보상 시퀀스를 표준 스키마로 저장하는 데이터 포맷.
- 확산 모델 (DDPM)
- 무작위 노이즈에서 시작해 여러 스텝에 걸쳐 노이즈를 조금씩 걷어내며 목표 데이터를 생성하는 확률 모델.
- 이산 코사인 변환 (DCT)
- 시간 흐름에 따른 신호를 주파수 성분으로 분해하는 변환(JPEG 압축의 핵심 원리).
- Byte Pair Encoding
- 자주 함께 등장하는 기호 쌍을 하나의 새 토큰으로 묶어 시퀀스 길이를 줄이는 무손실 압축 알고리즘.
- 오라클 (Oracle)
- 실제 환경에선 알 수 없는 정답 정보나 완벽한 하위 스킬을 외부에서 쥐여주는 이상적인 기준 조건.
- 가중치 고정 (Frozen)
- 사전학습된 모델의 파라미터를 전혀 재학습하지 않고 그대로 추론에만 사용하는 상태.
- 추론 지연 (Latency)
- 카메라 관측이 들어온 뒤 모델이 계산을 끝내고 행동을 내놓기까지 걸리는 대기 시간.
- 행동 묶음 (Action Chunk)
- 앞으로 실행할 H개 시점의 연속 행동을 하나의 행렬로 묶은 단위.
- Vision-Language-Action
- 카메라 영상(Vision)과 자연어 지시(Language)를 함께 받아 로봇의 물리적 행동(Action)을 직접 출력하는 멀티모달 정책 모델.
- Vision-Language Model
- 이미지와 텍스트를 동시에 이해하고 자연어 토큰을 생성하는 거대 멀티모달 모델.
- Large Language Model
- 대규모 텍스트를 학습해 언어 추론과 계획 수립을 수행하는 거대 언어 모델.
- End-Effector (말단 장치)
- 로봇 팔의 맨 끝에 달려 실제로 물체를 잡거나 조작하는 손목·그리퍼 부위.
- Vision-Language Navigation
- 시각 관측과 자연어 길 안내를 바탕으로 이동 로봇이 목표 지점까지 주행하는 연구 분야.
- Chain of Thought
- 모델이 최종 답이나 행동을 내기 전에 중간 추론 과정을 텍스트로 단계별 서술하게 하는 기법.
- Inverse Kinematics (역기구학)
- 손끝(EEF)의 목표 위치·자세가 주어졌을 때 각 관절이 몇 도씩 돌아가야 하는지 역으로 계산하는 기법.
- 토큰 (Token)
- 언어 모델이나 VLA가 텍스트, 이미지 패치, 로봇 행동을 처리하기 위해 쪼갠 최소 이산(또는 임베딩) 단위.
- 토크나이저 (Tokenizer)
- 연속적인 영상·행동 수치나 자연어 문장을 모델이 다룰 수 있는 토큰 시퀀스로 변환(및 복원)하는 모듈.
- 정책 (Policy)
- 현재 관측과 목표를 입력받아 다음에 취할 행동(또는 행동 확률 분포)을 출력하는 제어 모델 또는 함수 π(a|s).
- 강화학습 (RL)
- 정답 시연을 그대로 외우는 대신, 환경과 상호작용하며 얻은 보상(성공/실패 신호)을 최대화하도록 정책을 개선하는 학습 패러다임.
- 모방학습 (Imitation Learning)
- 사람이나 전문가의 시연 데이터(관측-행동 쌍)를 보고 그 행동을 따라 하도록 정책을 학습시키는 방식.
- 사전학습 (Pre-training)
- 특정 작업에 맞추기 전에 인터넷 규모의 방대한 멀티모달 데이터나 다종 로봇 데이터로 범용 표현과 상식을 미리 학습하는 단계.
- 시연 데이터 (Demonstration)
- 사람이 원격조작(teleoperation) 등으로 로봇을 직접 움직여 모은 ‘관측 → 행동’ 모범 궤적 데이터.
- 궤적 (Trajectory)
- 한 작업의 시작부터 끝까지 시간에 따라 이어지는 상태·관측·행동의 연속 시퀀스.
- 에피소드 (Episode)
- 로봇이 초기 상태에서 시작해 작업을 완수하거나 실패해 종료될 때까지의 한 번의 시행(trial) 단위.
- 관측 (Observation)
- 정책이 매 제어 스텝마다 외부 카메라(RGB 등)와 내부 센서(고유수용감각)로부터 받아들이는 현재 입력 정보.
- 그리퍼 (Gripper)
- 로봇 팔 끝(EEF)에 달려 물체를 집거나 놓는 집게·손가락 장치.
- 관절 공간 (Joint Space)
- 손끝의 3D 좌표가 아니라, 로봇 팔 각 관절(모터)의 회전 각도·속도 벡터로 움직임을 표현하는 좌표계.
- 프롬프트 (Prompt)
- 언어 모델이나 VLM/VLA에 작업 목표, 맥락, 예시 등을 전달하기 위해 입력으로 넣어주는 자연어 지시문 또는 멀티모달 질의.
- 멀티모달 (Multimodal)
- 텍스트, 이미지, 영상, 고유수용감각, 행동 수치 등 서로 다른 종류의 데이터(모달리티)를 함께 입력받고 처리하는 특성.
- 추론 (Inference)
- 학습이 끝난 모델의 가중치를 고정한 채, 실제 입력(카메라 영상·지시)을 넣어 행동이나 답을 계산해 내는 실행 과정.
- 제어 주파수 (Hz)
- 로봇 제어기가 1초에 몇 번씩 새 목표 자세나 모터 명령을 받아 실행하는지 나타내는 빈도(예: 50Hz = 20ms마다 1회).
- 회귀 (Regression)
- 정해진 이산 번호(bin)를 고르는 분류와 달리, 연속적인 실수 좌표나 속도 값을 직접 예측하는 방식.
- 벤치마크 (Benchmark)
- 서로 다른 모델과 알고리즘의 성능을 공정하게 비교하기 위해 정해 둔 표준 과제·환경·평가 지표 묶음.
- 오프라인 강화학습 (Offline RL)
- 학습 도중 로봇을 새로 굴려 데이터를 모으지 않고, 이미 저장된 과거 성공·실패 경험 데이터셋만으로 정책을 개선하는 강화학습 기법.
- 시뮬레이션 (Simulation)
- 실제 물리 로봇 대신 가상 물리 엔진 안에서 로봇과 물체의 상호작용을 재현해 빠르게 학습·검증하는 환경.
- 일반화 (Generalization)
- 학습 데이터에 똑같이 나오지 않았던 새 물체, 새 배경, 새 지시문, 새 배치에서도 정책이 망가지지 않고 작동하는 능력.
- RGB 영상
- 빨강·초록·파랑 3채널 색상 정보를 담은 일반 카메라 이미지 입력(깊이·촉각 센서와 대비될 때 주로 쓰임).
- 휴머노이드 (Humanoid)
- 두 팔과 두 다리 등 인간과 유사한 신체 구조와 높은 자유도를 갖춘 범용 로봇 형태.
- 양팔 조작 (Bimanual)
- 한 팔이 물체를 잡고 다른 팔이 뚜껑을 여는 등 두 로봇 팔이 협응해 수행하는 양손 작업.
- 가중치 (Weights)
- 신경망이 학습을 통해 조정하고 저장하는 내부 수치 파라미터. ‘오픈 웨이트’는 이 학습된 가중치를 공개한다는 뜻.
- 오픈소스 / 오픈 웨이트
- 모델의 코드·학습 가중치·데이터를 공개해 외부 연구자가 직접 실행하고 해부·미세조정할 수 있게 하는 생태계 방식.
- 노이즈 (Noise)
- 확산(Diffusion)·플로우(Flow) 생성 모델이 행동 궤적을 만들어 내기 위해 출발점으로 삼는 무작위(가우시안) 잡음 신호.
- 시퀀스 (Sequence)
- 트랜스포머가 한 번에 입력으로 받아 처리하는 순서가 있는 토큰들의 나열(예: 영상 패치 + 텍스트 + 행동 토큰).
- 제어기 · 제어 스텝 (Control Step)
- 로봇 저수준 제어기가 1주기(예: 50Hz면 20ms)마다 목표 자세나 모터 토크 명령을 하나씩 소비해 실행하는 최소 물리 시간 단위.
- 백본 (Backbone)
- 입력 영상·언어·상태에서 공통 특징 표현을 뽑아내는 모델의 핵심 몸통 신경망(예: PaliGemma, Llama 2, SmolVLM-2).
- 좌표계 (Coordinate Frame)
- 로봇의 위치·회전·행동 수치를 어느 기준점(로봇 베이스, 카메라, 손끝 EEF, 상대 변화량 등)에서 잴지 정하는 기준 틀.
- 좌표 정규화 (Normalization)
- 서로 다른 로봇·작업의 행동 범위(예: 관절 각도, 이동 거리)를 -1~1 또는 평균 0·분산 1 등 일정 스케일로 맞추는 전처리.
- Physical Intelligence (π)
- π0, FAST, π0.5, π*0.6, π0.7 등 범용 로봇 파운데이션 모델과 flow-matching VLA 계열을 개발한 로보틱스 AI 연구 기업.
- Action Expert (행동 전문가)
- VLM 백본 옆에 붙어 고유수용감각과 행동 노이즈를 전용 가중치로 처리해 연속 행동 궤적을 생성하는 경량 모듈(예: π0의 300M 모듈).
- 속도장 (Velocity Field)
- 플로우 매칭에서 노이즈 분포의 한 점이 목표 행동 분포의 한 점으로 어느 방향·속도로 이동해야 하는지 공간 전체에 정의한 벡터 함수.
- 상태 (State)
- 현재 시점의 로봇 내부 관절·그리퍼 수치(고유수용감각)와 환경의 물리적 배치를 포함하는 시스템의 현재 조건.
- 확률 보정 (Calibration)
- 모델이 출력한 신뢰도(예: 80%)가 실제 장기적인 정답·성공 비율(80%)과 일치하도록 점수 분포를 맞추는 성질.
- 사람 개입 (Human Intervention)
- 자율 실행 중 로봇이 실패하거나 위험한 동작을 하려 할 때 사람이 원격조작으로 즉시 교정해 주며 고품질 복구 데이터를 얻는 기법.
부록 D. 주요 모델 백본 · 규모 비교
이 글에서 다룬 주요 논문·모델의 시각 인코더, 언어·추론 백본, 행동 생성 헤드 및 파라미터 규모를 한눈에 비교한 표다. 각 수치와 구성은 1차 원논문·공식 발표 기준이다.
| 모델 / 논문 | 시기 | 시각(Vision) 백본 | 언어 · 추론 백본 | 행동(Action) 헤드 / 제어기 | 파라미터 규모 | 제어 주기 · 핵심 특징 |
|---|---|---|---|---|---|---|
| SayCan S02 | 2022.04 | — (어포던스 가치 함수) | PaLM (LLM) | 사전 정의 스킬 실행기 | 540B (PaLM 기준) | 상위 계획 · 언어 확률 × 어포던스 |
| SayPlan S01 | 2023.07 | 3D 장면 그래프(텍스트화) | GPT-4 | 고전 모션 플래너 + 스킬 | 비공개 (프론티어 LLM) | 건물·층·방 계층 그래프 탐색 |
| RT-1 S03 | 2022.12 | EfficientNet-B3 (FiLM) + TokenLearner | USE (언어 임베딩) | Decoder-only Transformer (256-bin) | ~35M | 3Hz · 1스텝 이산 행동 토큰 |
| Diffusion Policy S24 | 2023.03 | ResNet-18 (Visual) | 없음 | 1D Temporal U-Net / Transformer (DDPM) | ~66M–255M (태스크별) | 10Hz · 연속 chunk + 다중 모달 분포 |
| ACT S09 | 2023.04 | ResNet-18 (ImageNet) | 없음 | Transformer CVAE (Encoder + Decoder) | ~80M | 50Hz · 양팔 chunking + 시간적 앙상블 |
| RT-2 S05 | 2023.07 | ViT (VLM 통합) | PaLI-X / PaLM-E | VLM 텍스트 출력 공간 (256-bin 토큰) | 55B (PaLI-X) / 12B (PaLM-E) | 1~3Hz · 웹 VLM 공동 미세조정 |
| Octo S26 | 2024.05 | 경량 CNN (Patchify) | T5-base (언어 임베딩) | Transformer + Diffusion Action Head | 27M (Small) / 93M (Base) | OXE 80만 궤적 기반 오픈소스 |
| OpenVLA S07 | 2024.06 | DINOv2 + SigLIP (이중 비전) | Llama 2 (7B) | 자기회귀 이산 토큰 (256-bin) | ~7B (Prismatic-7B) | ~3~5Hz · 1스텝 예측 · 오픈 웨이트 |
| π0 S13 | 2024.10 | SigLIP (PaliGemma 통합) | PaliGemma (Gemma-2B + SigLIP) | Flow Matching Action Expert | ~3.3B (3B VLM + 300M Expert) | 최대 50Hz · 연속 행동 chunk 생성 |
| π0-FAST S11 | 2025.01 | SigLIP (PaliGemma 통합) | PaliGemma (3B) | DCT + BPE 이산 행동 토큰 (자기회귀) | ~3B | 고주파 연속 궤적 압축 토크나이저 |
| Figure Helix S27 | 2025.02 | VLM 통합 비전 인코더 | System 2: 오픈웨이트 VLM | System 1: Visuomotor Transformer | ~7B (S2) + ~80M (S1) | S2 7~9Hz / S1 200Hz 비동기 이중 구조 |
| NVIDIA GR00T N1 S28 | 2025.03 | Eagle-2 VLM 비전 인코더 | System 2: Eagle-2 VLM | System 1: Diffusion Transformer (DiT) | ~2.2B (N1-2B) | S2 + S1 이중 구조 · IDM 가상 라벨 공동학습 |
| π0.5 S15 | 2025.04 | SigLIP (PaliGemma 통합) | PaliGemma (CoT 서브태스크 추론) | Flow Matching Action Expert | ~3.3B (계열) | 열린 환경 일반화 · 의미+행동 공동학습 |
| SmolVLA S29 | 2025.06 | SmolVLM-2 비전 인코더 (64토큰 압축) | SmolVLM-2 (레이어 스킵) | Flow Matching Action Expert | ~450M | 비동기 추론 · 소비자 GPU 1장 실시간 |
| π*0.6 (+ RECAP) S30 | 2025.11 | SigLIP (PaliGemma 통합) | PaliGemma + Advantage 조건화 | Flow Matching + 오프라인 RL 가치 함수 | ~3.3B (계열) | 실패·교정 경험 기반 후속 학습 |
| Astra (GPT-6 Astra 등) S19 | 2026 | 범용 프론티어 VLM 비전 | 범용 프론티어 VLM | 텍스트 좌표 / 하위 목표 / 직접 출력 | 비공개 (프론티어급) | 무학습(zero-shot) 또는 프롬프트 기반 |
| Decision Models S31 | 2026.11 | 옴니모달 인코더 | 의사결정 전용 백본 (Gemini D1 / d1.2 / Jev) | 보정된 확률 (선택지 채점) | 비공개 / 경량 전용 | 자유 텍스트 생성 생략 · 저지연 라우팅 |